
聚焦正文
自动识别页面主体内容,导航、广告、页脚不会进入返回结果,正文保持页面原有的结构
结果数量计费 : 20积分/千次结果
自动识别页面主体内容,导航、广告、页脚不会进入返回结果,正文保持页面原有的结构

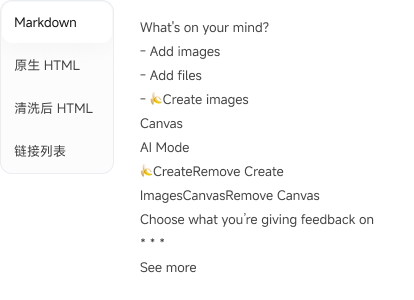
以 Markdown 返回提取内容,标题、段落等文本内容,可直接进入模型上下文或 AI 业务流程

支持 Markdown、原生HTML、清洗后HTML 与链接列表,选择适合当前任务的输出方式

获取指定网页中的全部链接,为资料收集、页面整理和后续提取提供目标清单
传入需要提取内容的网页 URL
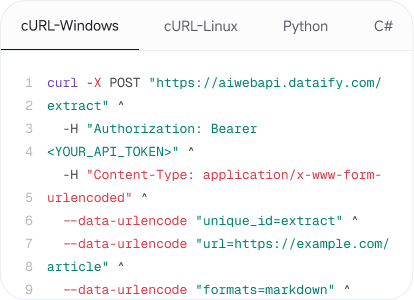
根据模型阅读、内容处理或链接整理需求,选择对应格式
将返回内容接入 AI Agent、知识库或业务系统
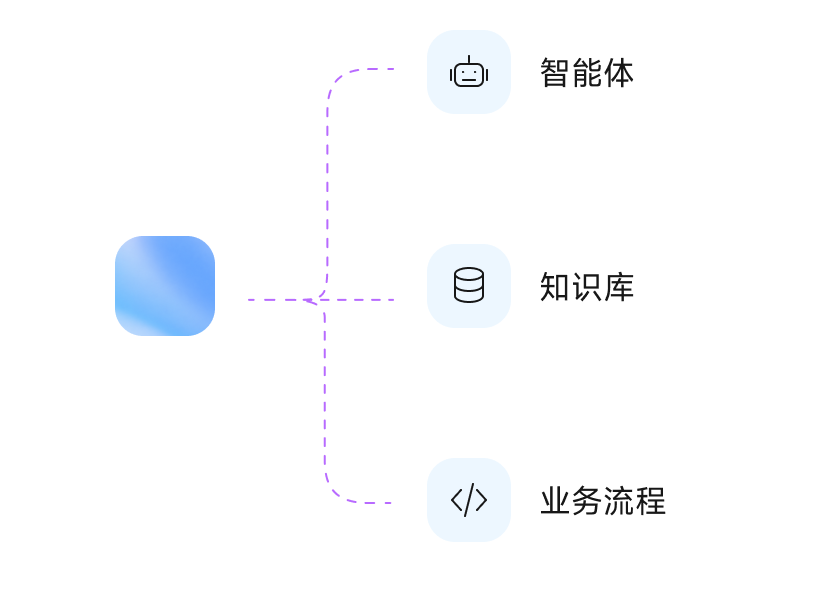


通过 MCP、Skills,将 Dataify 数据服务接入 AI 工具及
开发流程,简化工具配置与数据调用
将技术文档、行业报告、政策公告等指定网页提取为 Markdown,降低知识库搭建的内容清洗成本

信息系统已通过网络安全等级保护二级测评,持续强化边界防护、访问控制与日志审计能力

质量管理、信息安全与隐私保护体系均获国际认证
从流程到落地均有可审核的标准可循

以体系化机制保障数据全流程安全,采集有边界、
存储有分级、使用有审计
覆盖 Agent 获取网页数据全链路
Extract API 是网页内容提取接口。输入指定网页 URL,即可获取正文、标题、链接等内容,并按需输出 Markdown、原生 HTML、清洗后 HTML 或链接列表。
Search API 根据关键词查找相关网页,并可按需获取搜索结果中的网页正文。Extract API 面向已经确定的网页 URL,重点在内容提取、清洗与格式转换。
通用采集 API 主要解决网页访问与获取,输出 HTML 或 PNG。Extract API 更侧重网页内容提取和清洗,帮助用户获取便于 AI 阅读及后续处理的内容。
通常可以优先选择 Markdown,便于保留文本层次并接入后续处理流程。知识库建设仍需根据具体方案完成内容分段、向量化和入库等步骤。
Extract API 的链接列表来自指定网页,适合整理该页面中的链接;Map API 面向网站页面发现,帮助用户从网站入口获取更多站内 URL。
不能。Extract API 只处理公开可访问的页面,不绕过登录与验证码。这既是产品边界,也是合规要求。如果你的目标站点存在访问限制,建议先确认授权范围,或联系我们评估其他方案。